来源: How we saved 100 terabytes of memory by optimizing 1.1.1.1’s DNS cache | Cloudflare Blog
Big Pineapple是1.1.1.1、 Gateway DNS、 DNS Firewall、 AS112以及其他几项 Cloudflare DNS 服务背后的平台,它在任何给定时间都存储着超过 2500 亿条 DNS 缓存条目。如此庞大的规模,每条条目浪费一个字节,就会使我们的整个服务器群损失超过 250 GB 的内存。
通过对缓存条目在内存中的存储方式进行五次连续改进,每个条目的内存占用量减少了 50% 以上。在我们的所有服务器上,这些改进释放了大约 100 TB 的内存,相当于 130 台第 13 代服务器的内存容量。缓存速度也得到了提升。插入吞吐量提高了 43%,查找延迟降低了 19%,因为更少的内存分配和更好的内存局部性意味着我们无需为了节省空间而牺牲速度。
我们缓存的内容
冷启动时,Big Pineapple 的缓存为空。随着 DNS 查询的到来,缓存会逐渐被填满,直到达到最大条目数,此时我们会移除较旧或访问量较低的条目以腾出空间。
具体的缓存大小因数据中心而异。当使用扩展域名系统客户端子网 (ECS)时,权威服务器会根据客户端的网络返回不同的响应,因此我们会缓存同一查询的多个版本。这会增加缓存条目的数量以及每个条目消耗的内存,因此本文中的优化对于 ECS 使用频繁的地区尤为重要。
缓存中的每个项目都是一个键值对。键标识查询的内容:
pub struct CacheKey {
    qname: Name,
    qtype: Rtype,
    authenticated: bool,
    tag: Vec<u8>,
}
该值存储 DNS 响应本身:答案、权威机构和附加记录部分,以及元数据,例如创建时间、命中计数器和生存时间 (TTL)。
pub struct CacheEntry {
    timestamp: UnixTimeStamp,
    pub inception: Instant,
    pub ttl: Ttl,
    pub hits: u32,
    pub answers: Vec<Record>,
    pub authority: Vec<Record>,
    pub additional: Vec<Record>,
    pub errors: Vec<ExtendedError>,
    ...
}
这两个结构体都有改进空间。一些字段使用的类型会带来不必要的开销,而这些开销在条目存储后就不需要了。
内存使用情况基准测试
为了衡量每次更改的影响,我们通过向缓存中填充随机生成的条目来进行基准测试,这些条目大致匹配我们在生产环境中看到的流量分布:56% 的A 记录,25% 的记录AAAA ,以及 19% 的TXT 记录。每个条目包含一到四条记录。
TXT 记录类型代表基准测试中所有非A /AAAA 记录类型。它们的大小在 64 到 224 字节之间随机变化,接近于可变长度记录类型的平均响应大小。
我们使用自定义分配器来跟踪内存使用情况,该分配器封装了 Rust 的System 分配器,并记录每个缓存条目的分配次数和大小。除了内存使用情况,我们还测量整个缓存流程的插入吞吐量和查找延迟,以确保节省内存不会以牺牲性能为代价。
这些输入数据只能近似模拟生产环境,而不能完全复现实际生产环境。进程内存使用情况还取决于流量构成、缓存占用率、分配器状态以及缓存之外的内存使用情况。因此,我们在部署过程中测量了各个生产实例的驻留内存。
产能成本
Vec<T> 它存储三个字段:指向堆分配数据的指针、当前长度和总容量。当你向堆中添加一个元素时,它Vec 会检查该元素的长度是否超过容量,如果需要则重新分配内存。如果空间充足,它只会将该元素添加到堆末尾并增加长度。
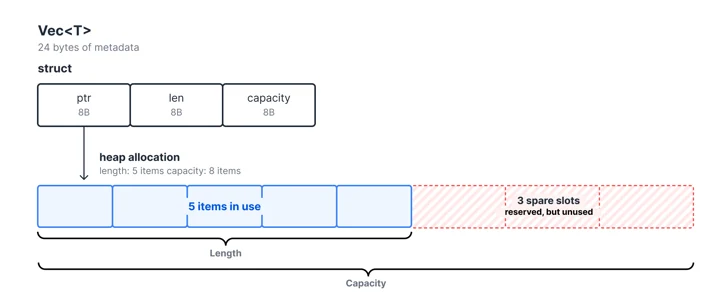
一旦我们将 DNS 响应存储到缓存中,就不会再对其进行修改。容量字段没有任何实际用途,但每个响应仍然占用 8 字节
Vec 。此外,过度分配的堆空间也被浪费了,因为一个Vec 容量为 8 个条目的缓存只存储了 5 个条目,导致堆上还有 3 个空位。
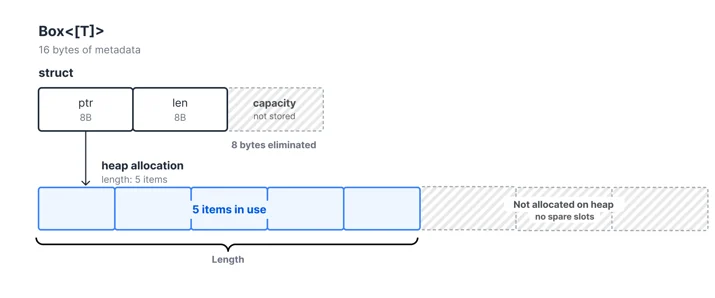
使用
<div> Box<[T]> 可以解决这两个问题。它创建后不会增长,因此不需要容量字段或为未来的元素预留空间。同样String ,<div> 也带有容量字段,而 <div>``Box<str> 则会移除该字段。
每个缓存条目存储 8 个Vec 字段String 。用 <string> 和 <string> 替换它们Box<[T]> ,Box<str> 每个字段可节省 8 字节,每个条目节省 64 字节。这还消除了为未来增长预留的额外堆内存Vec 。总共节省了超过 15 TB 的空间,缓存条目超过 2500 亿个。
减少列表,减少指针。
与其将答案、权威机构和其他部分存储在单独的列表中,我们可以将每个部分存储在一个列表中,并为每个部分设置偏移量。由于每个部分的 DNS 记录计数可以放入一个列表中u16 ,因此我们可以为每个偏移量使用一个列表u16 (2 字节),而每个单独的列表则需要 8 字节的指针和 8 字节的长度Box<[T]> 。
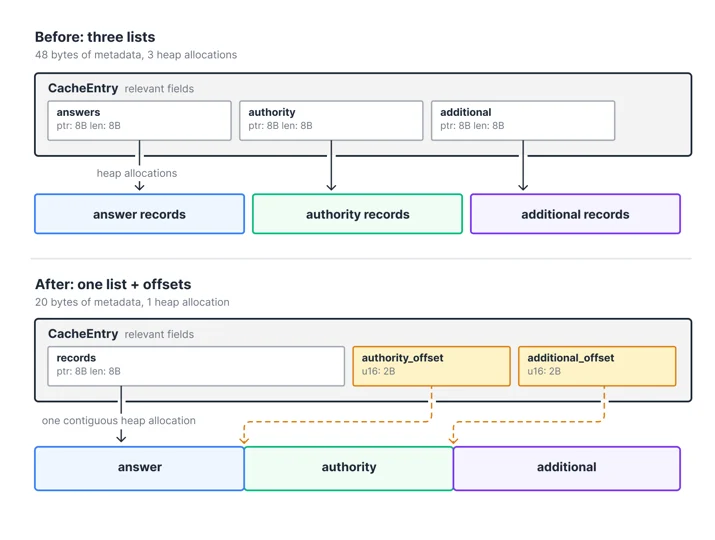
这样就删除了两个列表(每个列表都有一个 8 字节的指针和一个 8 字节的长度),并用两个 2 字节的偏移量替换了它们,每个条目节省了 28 字节。
这些节省并非总是直接对应于从单个字段中移除的字节数。Rust 会插入填充以满足对齐要求,并将结构体的大小向上取整到其对齐方式的倍数。因此,移除一个较小的字段可能会减少额外的填充。例如,我们还将几个布尔字段打包到一个bitflag中。这减少了周围的填充,使得结构体缩小的幅度超过了各个布尔值的大小。
甩掉所有者
每条 DNS 记录都有一个所有者,即该记录所属的域名。在很多情况下,这个所有者与被查询的域名相同。例如,查询 example.com 会example.com A 返回两条所有者相同的记录:
$ dig example.com A

;; ANSWER SECTION:
example.com.        300    IN    A        198.51.100.1
example.com.        300    IN    A        198.51.100.2
但是,当涉及到 a 时CNAME ,例如,记录所有者可能与查询的域不同:
$ dig example.com A

;; ANSWER SECTION:
example.com.        300    IN    CNAME    cdn.example.com.
cdn.example.com.    300    IN    A        198.51.100.1
cdn.example.com.    300    IN    A        198.51.100.2
DNS 传输格式使用RFC 1035中定义的名称压缩来处理重复的域名所有者。后续出现的域名不会编码两次,而是存储一个指向首次出现的 2 字节指针。例如,一个域名www.example.com 可以编码为 example.com,后跟一个指向该域名在消息中已出现www 位置的指针。example.com
这种方法在网络传输中效果很好,但我们在缓存中会将完整的所有者名称与每条记录一起存储。在热路径上查找缓存时跟踪压缩指针开销很大,因此我们用内存换取速度。
然而,大多数记录的所有者与查询的域相同。对于这些记录,我们可以完全省略所有者信息,并在读取时推断所有者。当所有者不同时,例如A 某些记录CNAME ,我们会存储完整的所有者名称。
pub struct Record {
    owner: Option<Box<Name>>,
    class: Class,
    ttl: Ttl,
    rtype: Rtype,
    data: RecordData,
}
当值为owner 真时None ,响应构造会从缓存键恢复查询的域,从而避免堆内存分配。这意味着记录不再是自包含的,但缓存键在每次查找时都已可用。当所有者不同时,Some 会存储指向堆上完整名称的指针。
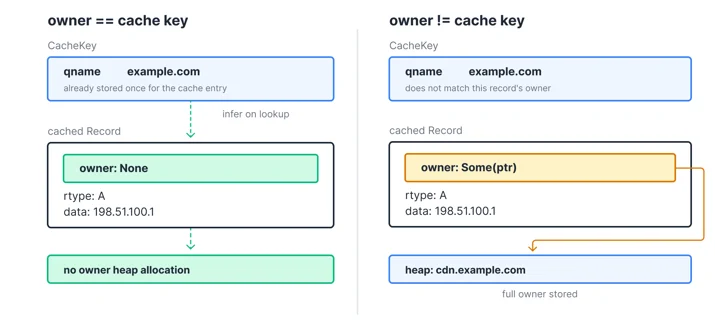
实际上,大多数缓存记录的所有者与查询域的所有者相同,因此大多数记录不需要为所有者字段分配堆内存。
枚举大小
Rust 枚举是和类型:每个变体可以携带不同的数据,但枚举的大小始终是其最大变体的大小。
pub enum Option<T> {
    Some(T),
    None,
}
Option 要么是空的Some ,并且包含一个值;要么是空的,并且None 不包含任何值。两种情况占用的内存量相同。枚举存储一个标签,指示当前激活的变体,后跟足够容纳最大变体数据的空间。当变体为空时None ,该空间未被使用。
对于记录数据,将每种 DNS 记录类型存储为枚举类型似乎很自然:
pub enum RecordData {
    A(Ipv4Addr),
    Aaaa(Ipv6Addr),
    Txt(Txt),
    Naptr(Naptr),
    Svcb(Svcb),
    // ...
}
但枚举值的大小始终与其最大变体相同。在本例中,最大变体的大小NAPTR 为 136 字节。它存储了三个可变长度的文本字段、一个域名和两个整数。因此,包含变体标签和填充在内的完整枚举值将达到 144 字节。
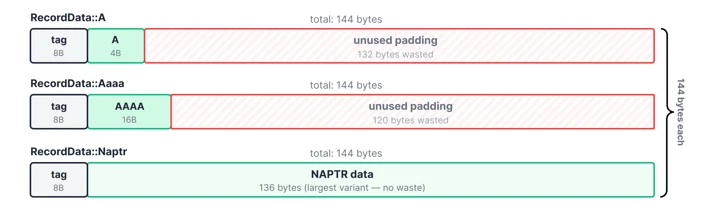
一条
A 记录只需要 4 个字节,而另一条记录却AAAA 需要 16 个字节。这两类记录占我们流量的 80% 以上,因此大多数记录都会浪费超过 120 个字节用于填充。由于单个缓存条目可以存储多条记录,因此这种浪费会迅速累积。A AAAA
复制链接将这些变体装箱
为了解决这个问题,我们可以将枚举中较大的变体装箱,并将它们移动到单独的堆内存中。枚举随后存储一个指向堆内存的 8 字节指针,数据本身只占用实际需要的空间。
pub enum RecordData {
    // Small and common variants are stored inline
    A(Ipv4Addr),
    Aaaa(Ipv6Addr),
    // Large variants are stored on the heap
    Txt(Box<Txt>),
    Naptr(Box<Naptr>),
    Svcb(Box<Svcb>),
    // ...
}
对于A int 和 AAAA int 记录,每条记录可节省 120 字节。较小的变体类型(例如 int 和 int)TXT 也CNAME 能从中受益。它们仍然占用 24 字节的枚举空间,但它们的堆分配大小与其实际数据大小相同,而不是填充到 144 字节。NAPTR 最大的变体 int 实际上付出的代价略高。它现在增加了堆指针和分配开销的成本。但NAPTR 实际上 int 记录很少见,因此这种权衡是值得的。
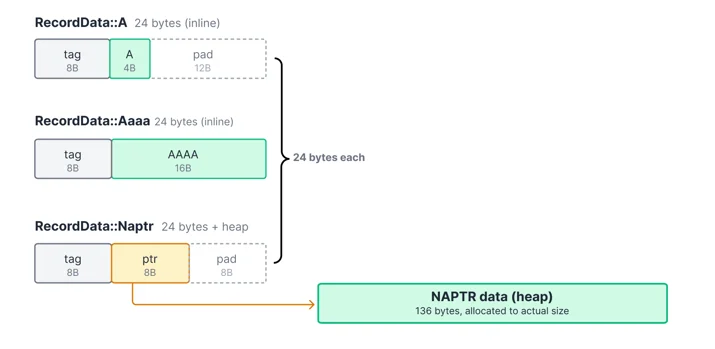
但是,将尺寸较大的唱片装盒包装也会带来额外的成本。
boxing 的成本
装箱操作有两个成本。首先是分配器的开销。每个装箱后的内存变体都会被分配到单独的堆内存,分配器会向上取整到最接近的大小级别。Big Pineapple 使用了jemalloc,这是一款专为多线程、内存分配密集型工作负载设计的分配器。jemalloc 将大小相近的内存分配分组到固定大小的桶中。例如,一条TXT 记录请求 32 字节,正好可以放入一个 32 字节的桶中,没有任何浪费;但如果一条MX 记录请求 40 字节,则会向上取整到 48 字节,造成 8 字节的浪费。
第二个代价是内存局部性差。如果没有装箱,缓存条目的枚举值会存储在一个连续的内存区域中。而有了装箱,每个装箱变体的数据都位于单独的堆区域中。读取这些数据需要追踪一个指针,当该指针指向远离条目其余部分的位置时,CPU 就必须获取新的缓存行。当缓存条目达到数百万时,装箱数据最终会分散在整个堆中,而不是集中在一起。
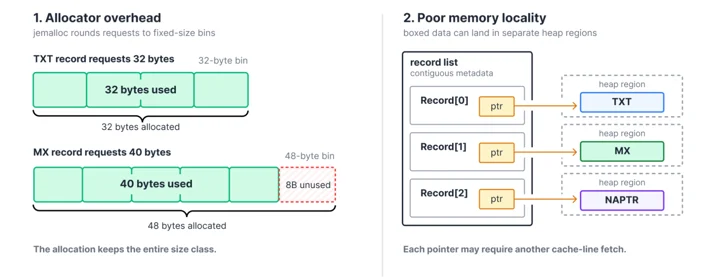
单独来看,这两项成本都不算灾难性的,但正如下一节所示,消除这两项成本可以显著改善内存使用情况和查找延迟。
以电子线缆格式存储记录
显而易见的下一步是将完整的 DNS 响应以网络传输格式存储,每次查找时仅对客户端特定的字段(例如消息 ID)进行修补。但这存在一些缺点。只有当客户端设置了DO(DNSSEC OK)标志时,才会包含 DNSSEC 记录。存储完整的网络传输格式消息意味着要么缓存两个版本(一个包含 DNSSEC,一个不包含),要么从已构建的消息中过滤掉 DNSSEC 记录。此外,每次查找时解析完整消息也会带来额外的开销,而我们刚才描述的枚举方法通过存储已解析的记录来避免了这一点。
作为一种折衷方案,我们仅将记录数据以原始字节形式存储,而将缓存条目的其余部分保留为结构化字段。我们不使用已解析枚举变体的列表,而是将记录存储为一个Box<[u8]> 包含所有记录的单一对象,每个记录都以 2 字节长度的前缀及其原始字节进行编码。
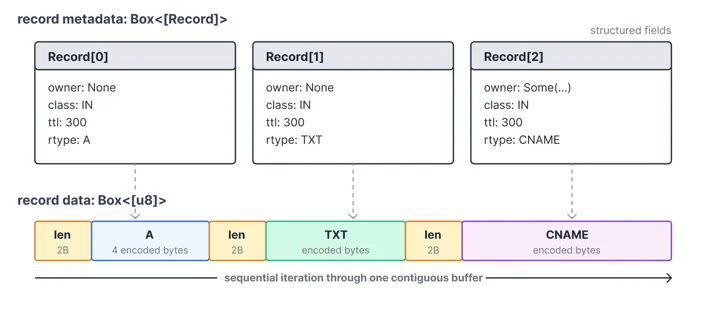
这消除了之前优化中每个变体枚举的开销和装箱堆分配。数据也变得连续打包,从而提高了 CPU 缓存局部性。但缺点是记录不能再随机索引。我们必须按顺序遍历缓冲区。这为诸如循环轮询记录之
A 类的功能增加了一些复杂性AAAA ,但由于每个条目的记录数很少,因此成本可以忽略不计。
在从缓存记录构建 DNS 响应时,大多数记录类型可以直接从缓冲区复制到传出消息中。以前,每个解析后的记录都必须逐字段序列化回 DNS 传输格式。新的布局通过直接复制编码后的字节,跳过了对 <example.com>、<example.com>、<example.com> 和所有 DNSSEC 记录类型的这种工作A 。AAAA 只有TXT 包含域名的记录(例如CNAME < example.com>、 NS < MX example.com>、<example.com> 和 <example.com> SOA )仍然需要解析,以便应用 DNS 名称压缩。由于支持直接复制的记录占我们流量的绝大部分,因此这项更改减少了查找路径上的工作量。结合改进的内存局部性,在我们的基准测试中,缓存查找延迟降低了 5%。
为了构建记录数据缓冲区,我们写入一个可重用的临时空间缓冲区,该缓冲区在缓存插入操作中保持不变。由于之前的写入操作已经使其增长,因此该缓冲区很少需要重新分配。记录的大小各不相同,因此在序列化之前我们无法确定缓冲区的确切大小。记录进入临时空间缓冲区后,我们会分配一个内存空间Box<[u8]> 并将memcpy 数据写入其中。这取代了之前为每个装箱记录单独分配内存的做法,取而代之的是为所有记录数据分配一次内存。此外,它还避免了因缩小内存空间而造成的浪费Vec<u8> ,因为在这种情况下,分配器可能无法回收原始分配中未使用的尾部空间。在我们的基准测试中,仅此一项更改就使缓存插入吞吐量提高了 13%。
结果
生产环境测量结果显示了基准测试中每个条目的内存节省如何转化为整个进程的驻留内存。下图显示了 Big Pineapple 实例中 p90、p98 和 p99 的内存使用情况。第一条虚线标记了 2026 年 5 月 18 日的部署开始日期,第二条虚线标记了 2026 年 7 月 6 日所有服务的部署完成日期。每个版本都引入了上述一项或多项优化,因此内存使用量是逐步下降的,而不是一次性下降的。
每次版本发布后,重启的实例初始缓存为空,随着缓存逐渐填满,内存消耗量也会增加。因此,稳定的内存使用量平台期比初始的内存使用量低谷期更能代表稳态内存使用情况。
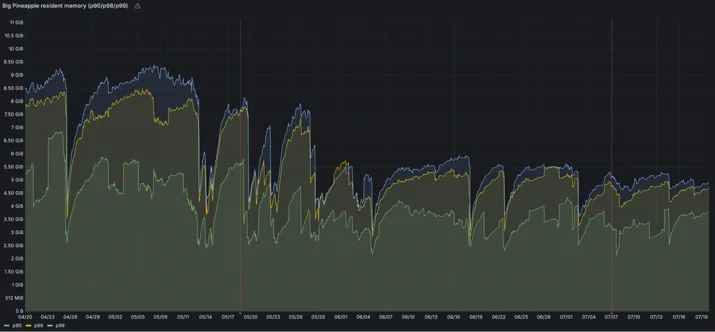
所有百分位数的实例内存使用量均有所下降。在 p99 时,内存使用量从 9.3 GB 降至 5.3 GB,减少了 43%。在 p90 时,内存使用量从 6.5 GB 降至 3.8 GB,减少了 42%。缓存较满的实例的绝对内存节省量最大。
在我们的基准测试中,这五项优化将每个条目的内存占用从 953 字节减少到 420 字节,降幅达 56%。每个条目的内存分配量也从 1.1 KB 降至 461 字节。由于生产环境中的驻留内存包含缓存以及所有其他进程数据,因此实际测得的内存减少量较小。优化部署完成后,整个集群的工作集内存总量减少了约 100 TB。
性能也得到了提升。缓存插入吞吐量提高了 43%,而查找延迟降低了 19%。
| Metric | Before | After | Change |
|---|---|---|---|
| Per-entry net footprint | 953 bytes | 420 bytes | -56% |
| Per-entry allocations | 1.1 KB | 461 bytes | -58% |
| Cache insert throughput | 625,000 entries/s | 893,000 entries/s | +43% |
| Cache lookup latency | 828 ns | 670 ns | -19% |
我们计划将释放出来的内存重新投入到提升缓存容量上,同时保持内存使用量不变,这样可以提高缓存命中率并减少上游查询量。我们还在探索对缓存本身进行进一步优化的方法。