来源: skyline-speeder/README.zh.md at main · CYBERVERSE-Research/skyline-speeder · GitHub
这是什么
Skyline Speeder 是一套单边 TCP 加速软件:以 eBPF 程序的形式只运行在发送数据的服务器上,面向丢包严重、往返时延长、标准 TCP 在其上几乎跑不起来的链路。它的做法是让发送速率保持在这条路径实际能交付的水平,而不是每丢一个包就把速率砍下来,以此提高这类链路上的吞吐。接收端不做任何改动。
原理
BBR 靠估计带宽而不是对每次丢包作出反应,但它仍会向丢包让步:内核里的 BBR 每次进入丢包恢复都会先退到"包守恒"(收到几个确认才发几个包),每次超时重传后更是从 1 个包重新开始。在一条与排队无关、随机丢掉 10%-20% 报文的链路上,丢包恢复和超时成了常态,RTT 在 100-300 ms 时它的吞吐逐次运行起伏很大,经常直接崩掉。Skyline Speeder 在发送端用 eBPF 实现的 tcp_congestion_ops(struct_ops)替换拥塞控制,并只基于一个前提:丢包本身不携带拥塞信息。
- 速率来自测量,而不是丢包。 每一轮测量投递速率(取最近几轮的峰值)和基准 RTT;每个 ACK 到来时,在包括丢包恢复在内的所有 TCP 状态下,直接把窗口设为
带宽 × 基准 RTT × 增益。丢包本身永远不会让窗口缩小,也没有需要慢慢爬出来的"包守恒"阶段。 - 丢包补偿。 在丢包率为
p的路径上,投递速率比实际需要发送的量少了(1 - p)。窗口和速率会按这条流自己测得的丢包率放大1 / (1 - p),最多放大到配置的上限。 - Pacing。 数据经
fq队列以带宽 × 增益 × 补偿系数的速率均匀发出,而不是成批倾泻,并受硬性速率上限约束;窗口只需要不成为瓶颈。 - 两个阶段。 STARTUP 用较高的增益尽快摸到路径带宽;带宽连续几轮不再增长后,进入 CRUISE。
- 拥塞护栏。 只有两个信号算真实拥塞:排队时延超过阈值(固定值与基准 RTT 的一定比例取较大者),以及 ECN 标记。任一出现,这一轮的增益就降到
guardrail_gain,低于测得的带宽;下一轮信号消失即恢复。 - 有上限的 RTO(可选)。一个 cgroup sockops 程序按连接限制内核的重传超时,避免线路抖一下就让连接最长等上两分钟。
- 首轮冗余(默认开启)。在这样的链路上,拖慢短响应的不是窗口,而是等丢包恢复:尾丢探测约两个往返、重传超时约三个往返、丢了 SYN-ACK 固定等一秒。一个 TC 出方向程序把每条 skyline_cc 连接的握手包和前 64 KiB 各发两份,第二份比原包晚 10 ms,丢一个包只多等这几毫秒,而不是等一个计时器。代价是每条连接最多多发 64 KiB。
Rust 编写的 skyline-speederd 负责加载 BPF 对象(每个对象加载时都要过内核验证器),并通过双缓冲槽在线下发新系数,每条流在 RTT 边界切换过去;ssctl 是它的命令行。
Important
这个前提只对与排队无关的丢包成立。 如果链路的丢包其实是拥塞瓶颈上的排队溢出,丢包补偿与排队护栏会朝相反方向用力,只会更糟。简单判断:固定速率的 UDP 打流不丢包、TCP 却大量重传,说明丢包是自身突发造成的排队溢出,这时不该用本工具。它也不追求公平:不会刻意和竞争的流平分链路。
实测性能
bbr、tcp-brutal 与 skyline_cc 在一条真实跨境链路上的对比,三者都只部署在服务端,通过同一套按目的地前缀的路由覆盖生效,客户端全程使用原生 TCP。
| 位置 | 角色 | |
|---|---|---|
| 服务端 | 新加坡 KVM VPS · 10 Gbps | 发送方,唯一被加速的一端 |
| 客户端 | 阿里云 ECS,华南(广东) · 200 Mbps | 接收方,原生 TCP,不做任何改动 |
RTT 70-73 ms、丢包 10%-30%,测于晚高峰。skyline_cc 使用 0.1.0 时随附的默认系数,即现在 使用与调参指南 里的「高随机丢包档」;当前的默认系数没有在这条链路上测过。tcp-brutal 为 v2.0.0,速率 200 Mbps;bbr 为内核自带版本。
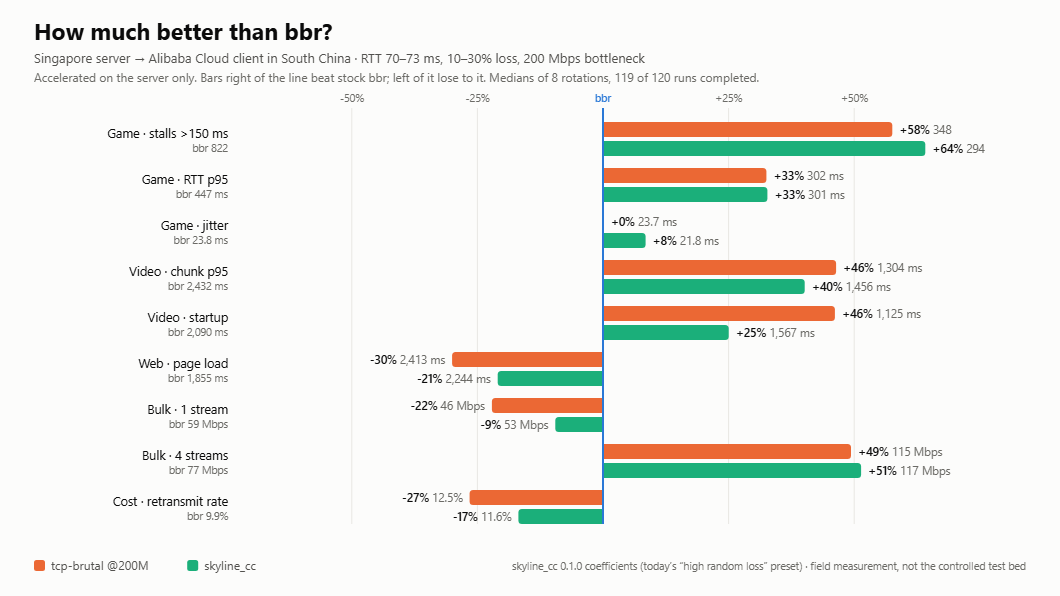
8 轮 × 3 算法 × 5 场景 = 120 次运行,119 次完成。每轮轮换算法顺序,避免链路在测试中劣化时偏袒先跑的那个。各场景赢家按轮统计:
| 场景 | 赢家 | 幅度 |
|---|---|---|
| 视频(6 MB 分块 @ 48 Mbps) | tcp-brutal | 启动延迟赢 7/8 轮,分块 p95 赢 6/8 轮 |
| 游戏(ping-pong,60 msg/s) | skyline_cc | 抖动 5/8 轮,卡顿 >150 ms 4/8 轮 |
| 大文件 · 4 并发 | skyline_cc 与 tcp-brutal,都领先 bbr | 中位数 117 / 115 vs 77 Mbps |
| 大文件 · 单流 | bbr 与 skyline_cc 打平,tcp-brutal 垫底 | 4/8、4/8、0/8 轮;中位数 59 / 53 / 46 Mbps |
| 网页加载 | 无稳定赢家 | 逐轮波动大于三者差异 |
| 服务端重传率(全部场景累计) | bbr 最低 | bbr 10.0%、skyline_cc 11.6%、tcp-brutal 12.3% |
最能说明三种设计差别的是单流结果。tcp-brutal 发得最多、传得最少:它发出的报文段有 13.9% 是重传,bbr 为 9.9%,skyline_cc 为 11.1%,而它的中位吞吐只有 46 Mbps。 在 10%-30% 丢包下,它固定的 200 Mbps 远高于这条路径能交付的速率,而"丢了就多发"的开环控制把这个差距全部变成了重传。skyline_cc 自己估计速率,没有一个会被设得过高的目标速率。
Note
这是一条链路上的现场测量,不是本仓库正式结论所依据的受控双 VM 测试床,也不代表你的链路。它 70 ms 的 RTT 还低于本项目 100-300 ms 的目标区间,在这个 RTT 下 bbr 从丢包中恢复要容易得多。请把它当作三种算法行为特点的证据,而不是吞吐量跑分。逐轮数据与原始记录见 research/experiments/single-ended/;受控测试床结果见 性能验证报告。
三者的设计差别
| bbr | tcp-brutal | Skyline Speeder | |
|---|---|---|---|
| 控制结构 | 闭环,探测带宽 | 开环:速率由你给定 | 闭环,自己估带宽 |
| 因丢包降速 | 间接 | 否 | 否 |
| 需要预知链路带宽 | 否 | 是 | 否 |
| 拥塞自保护 | 有 | 无 | 排队时延 + ECN 护栏 |
| 形态 | 内核内置 | 内核模块(DKMS) | eBPF CO-RE,过验证器 |
| 内核门槛 | 任意 | 5.10 | 6.12 LTS |
如果你知道出口带宽、它基本固定、且内核较老,tcp-brutal 是更简单的答案。Skyline Speeder 适合带宽未知或会变、需要拥塞护栏与可观测性、且能跑 6.12+ 内核的场景。真正拥塞的瓶颈链路上,两者都不合适。