来源: https://www.anthropic.com/research/ecdsa-curve-origins
“它只是时间戳”:困扰人们数十年的最流行的加密标准之一的起源之谜终于得到了解释。
我们着手解决密码学界长期以来存在的这个悬而未决的问题,以消除人们对 ECDSA 的担忧,ECDSA 是我们最广泛使用的密码学标准之一。
相关文章
前线红队
2026年10月22日
LLM(逻辑逻辑模型)使得形式化软件验证能够在更大的范围内成为可能。
查看更多
读者们应该把这看作是一个轻松愉快的收官之作,也是多年猜测的终结。无需采取任何行动,也无需改变任何事情。大多数研究人员早已对这些曲线深信不疑。尽情享受吧。
ECDSA 是应用最广泛的椭圆曲线密码学标准。它于 2000 年被美国国家标准与技术研究院 (NIST) 采纳,并纳入FIPS 186-2 数字签名标准。该标准列出了一系列不同大小和安全级别的标准椭圆曲线。对于定义在素数域和二进制域上的曲线,规范中公布了一个“种子”参数,其哈希值用于定义曲线的系数 b。这些种子的来源一直是一个悬而未决的问题,因为它们是由美国国家安全局 (NSA) 提供的,但没有任何解释或依据。例如,NIST P-256 曲线的种子就SEED = C49D3608 86E70493 6A6678E1 139D26B7 819F7E90没有任何关于其来源的信息。
尼尔·科布利茨和阿尔弗雷德·梅内塞斯就这场争议撰写了一篇精彩的总结文章《谜中谜》,探讨了种子价值的历史及其引发的担忧。这一谜团引发了一场业余人士对种子起源的调查,并悬赏寻找种子的人。
最精彩的故事是,美国国家安全局的长期雇员杰里·索利纳斯使用一个幽默口令的哈希值生成了种子:
“我相信当时用的是计数器而不是多重哈希,但我不清楚具体细节。信息大概是‘给鲍勃和杰瑞涨工资’或者‘鲍勃和杰瑞最棒’之类的。代码是鲍勃·雷特写的,但他自己也记不清细节了。我们也没能找到那么久远的存档。如果真有的话,它们肯定在某个硬盘里,就在约柜附近。”
杰瑞·索利纳斯,2015年
不幸的是,杰瑞于 2023 年去世,当时的其他同事也没有回应,这使得这些种子最初是如何获得的这个问题仍然悬而未决。
克劳德找到了种子
几位Anthropic员工曾根据线索追查种子来源,认为种子是由一句幽默短语的缩写构成,但最终都无功而返。事实证明,这个线索是错误的。2026年10月,一位好奇的Anthropic员工询问公司内部的研究模型,能否在不提供线索的情况下,找出这些种子的生成方式。
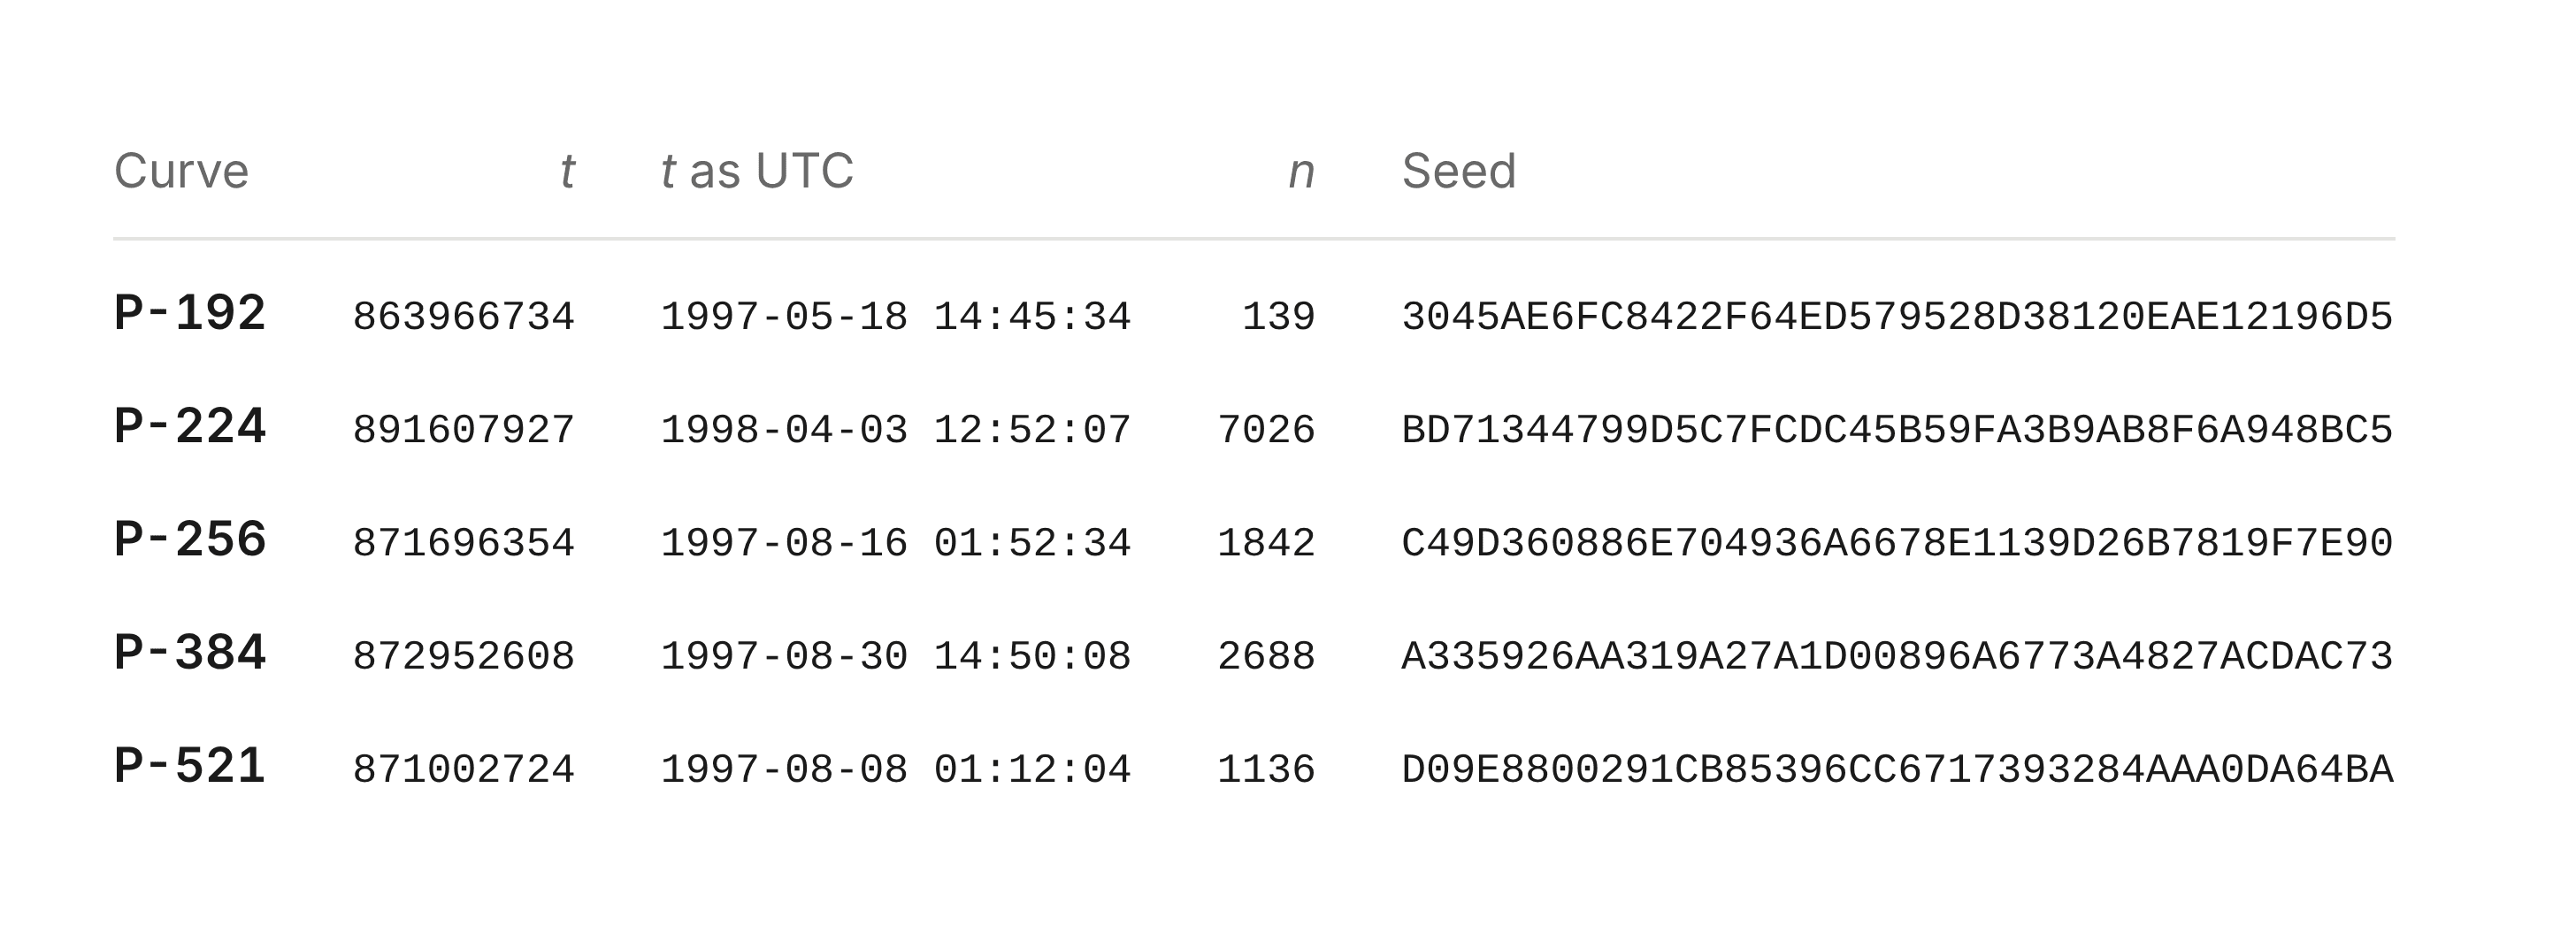
不到半小时,克劳德就发现了 NIST P-192、P-224、P-256、P-384 和 P-521 种子的来源。它们根本不是任何哈希算法的结果,而是 C 库的lrand48随机数生成器的输出,并以 Unix 时间戳作为种子!
该算法会从由 Unix 时间戳 ( t ) 初始化的随机数生成器 (RNG) 中抽取字节,并进行若干次迭代 ( n )。每次迭代抽取 20 个字节作为候选种子。因此,前 20 个字节是候选种子 1,接下来的 20 个字节是候选种子 2,依此类推。例如,P-256 算法需要 1842 次迭代才能输出标准化的种子。
这意味着什么
这并非密码学上的突破、新的攻击或ECDSA曲线本身的弱点。事实上,这让我们更加确信这些曲线的选择过程中没有任何后门或人为设置的漏洞。多年来,人们一直对NIST曲线参数的来源抱有怀疑。这些参数提交给NIST时并未说明其选择方式,这让人们不禁怀疑其中是否包含故意设置的后门。而这些发现大大降低了这种可能性。种子生成的方式非常简单:使用一个常见的伪随机数生成器,并根据时钟进行初始化,现在任何人都可以复现这一过程。这大大减少了被篡改的空间,也让我们确信这些参数是安全的。
它是如何被发现的
根据传言拼凑起来的短语进行搜索,却一无所获。克劳德尝试了另一种方法:推测生成这些曲线的软件是如何工作的。他猜测该软件使用了伪随机数生成器(PRNG),这种生成器通常随20世纪90年代的C语言库一起发布。这些老式PRNG的精度很低,其输出可以被识别。识别出输出结果就能揭示所使用的PRNG是哪种,甚至有可能恢复其初始化状态。
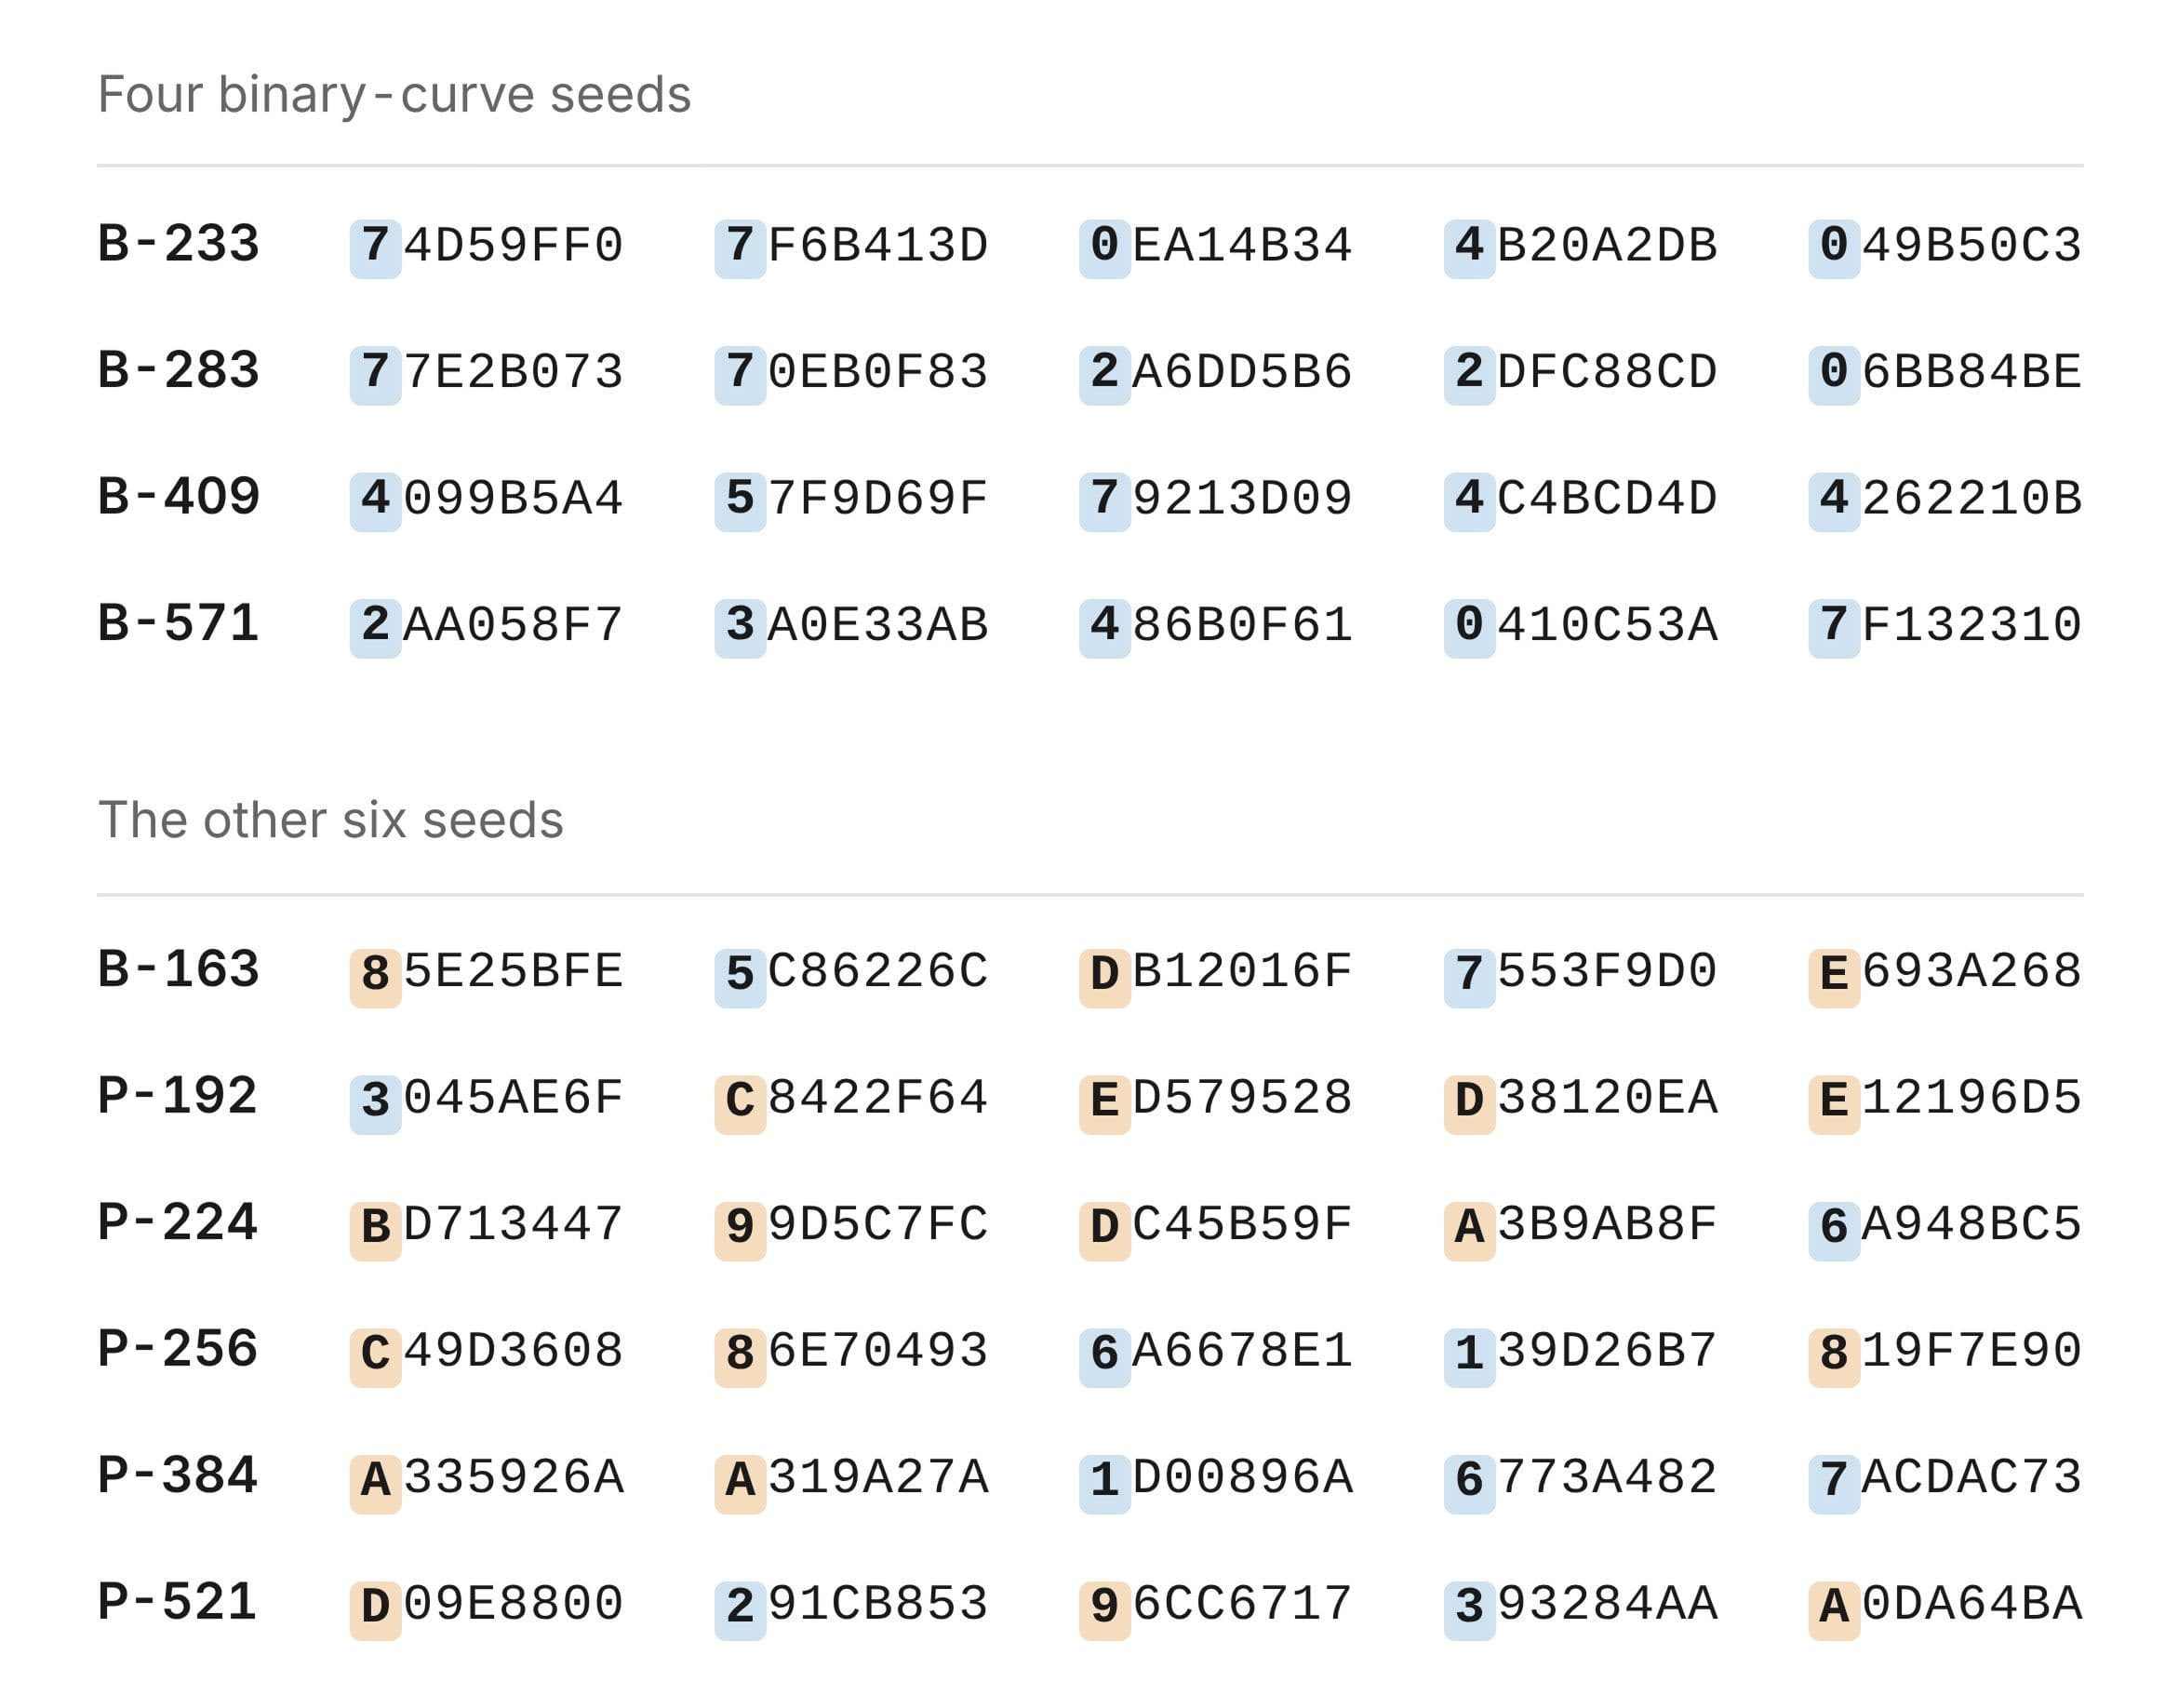
克劳德编写了一个扫描器,它逐位扫描每个已发布的种子,并测试相邻的数据块是否是上世纪90年代老式生成器的连续输出。扫描涵盖了34种生成器和输出切片的组合。这时,克劳德注意到某些种子的最高位存在一个模式:它们全部为零。十个种子中有四个以五个32位字表示,且所有20个字的最高位均为0。这种情况偶然发生的概率为1/5810。这是线性同余生成器的特征lrand48,它只返回48位状态的最高31位。一旦你知道该寻找什么,这个模式就显而易见。为了恢复状态,克劳德取第一个字,尝试了17个隐藏位的所有2¹⁷个值,并检查接下来的四个字是否符合这些值。这种方法对所有讨论的四个种子都有效。
这些素数曲线种子来自同一个 lrand48 生成器,但每个输出保留的位数较少。Claude 需要从这些位数中恢复伪随机数生成器的内部状态。事实证明,恢复截断线性同余生成器的状态是一个典型的格问题,可以使用Lenstra-Lenstra-Lovász (LLL)基约简算法来解决。Claude 不知道种子可能显示状态的哪些位数,因此它对每个窗口都运行了求解器。五个 NIST 素数曲线种子加上另外五个来自 ANSI X9.62 标准的种子都具有相同的模式:lrand48() >> 23。每个恢复的 48 位状态都重新生成了其种子的全部 160 位,这并非偶然。
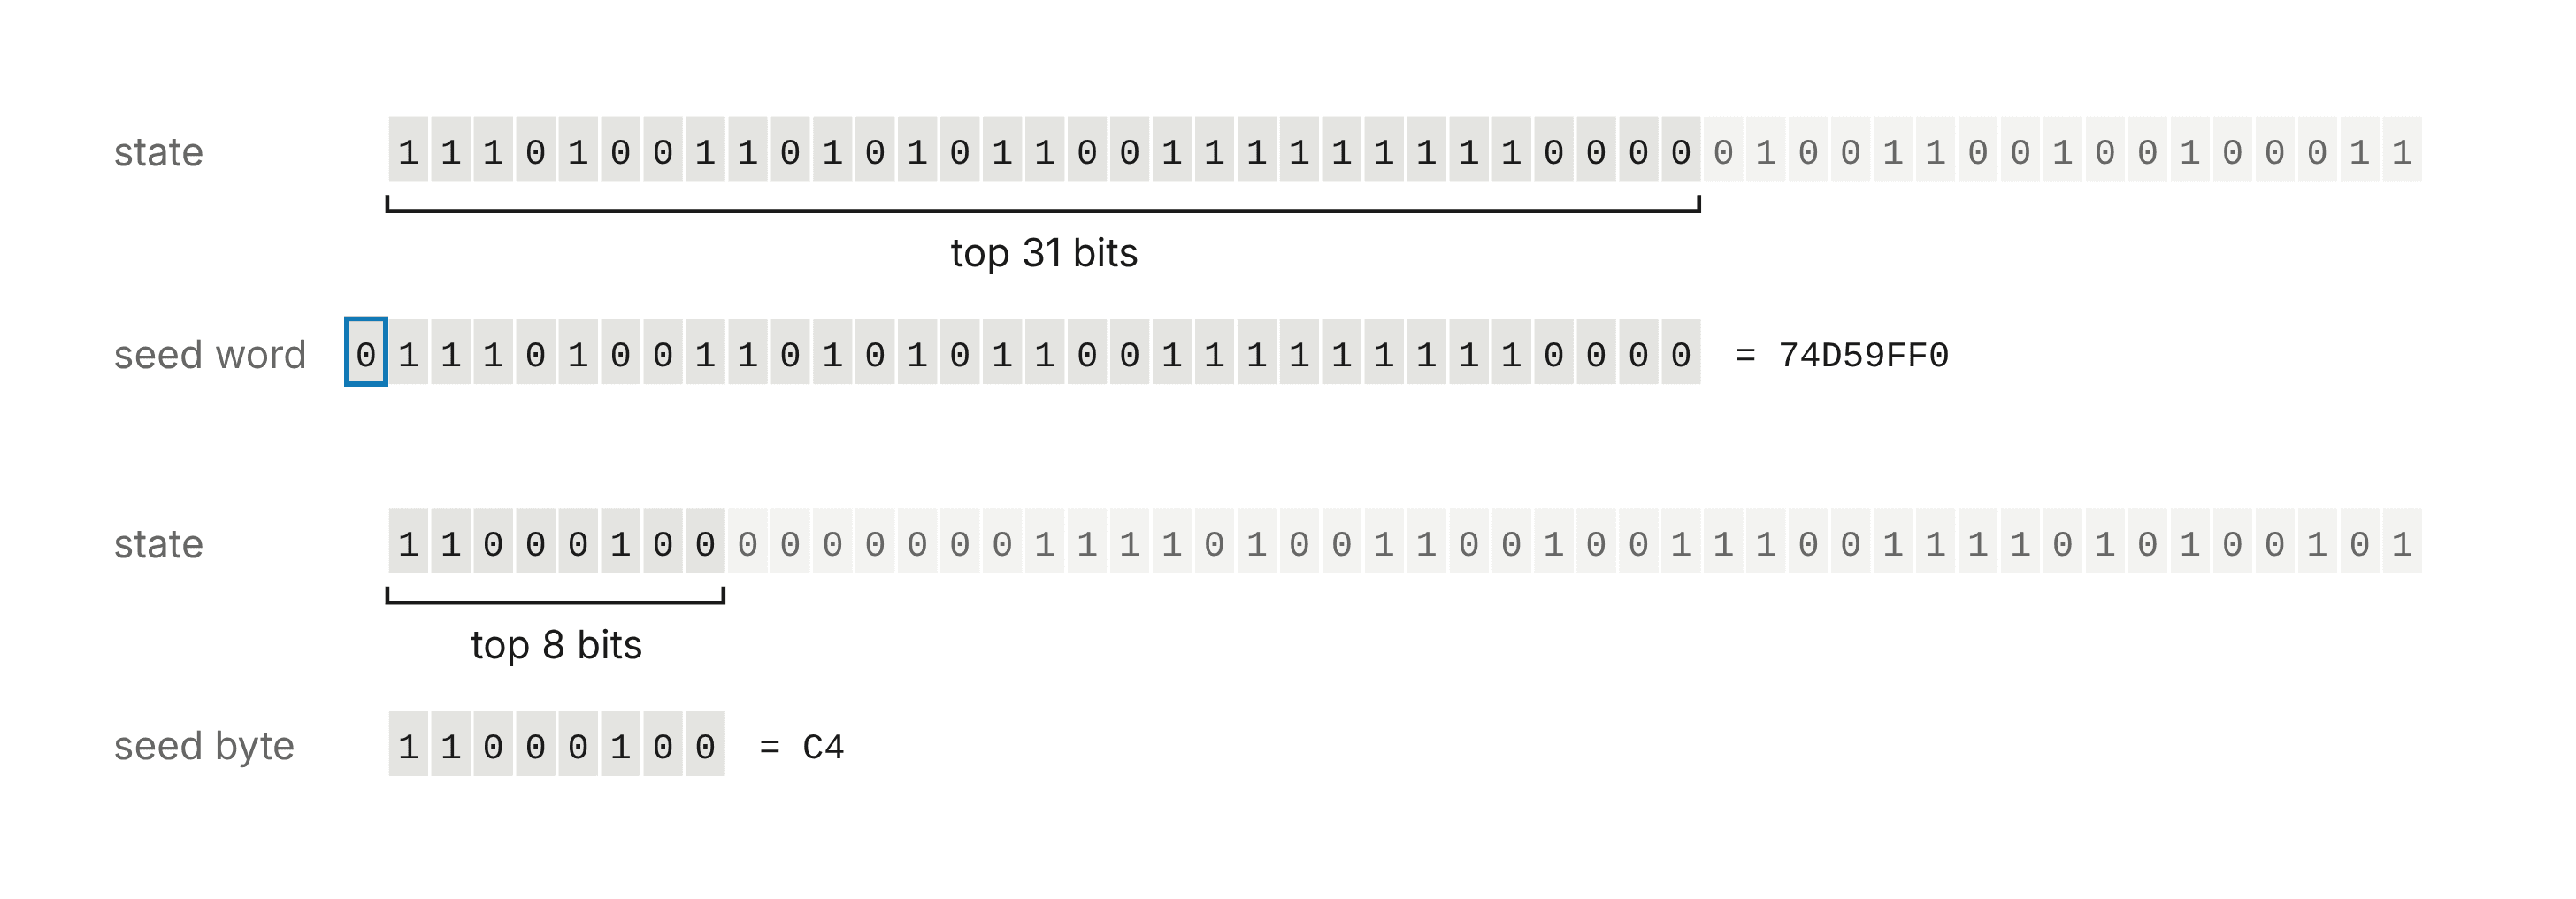
这个线性同余生成器正向和反向运行一样容易,因此对于每个种子,Claude 都会将状态回退,直到它达到srand48初始化时的状态,即低 16 位等于 0x330E。这种形式的内部伪随机数生成器状态每 65,536 步会出现一次,因此达到这种状态本身并不能作为证据。
然而,对于十个素数曲线种子,每个 srand48 初始化都对应一个 Unix 时间戳,代表 1997 年 5 月到 1998 年 4 月之间的日期。他们使用的是由 Unix 时间戳初始化的弱伪随机数生成器 (PRNG)。四个二进制曲线初始化的时间戳均为 1984 年 2 月。将时间戳翻倍后,它们对应到 1998 年 4 月 17 日,即 P-224 运行两周后。因此,该程序可能将时间减半了。
克劳德当时的内心想法是:
这太惊人了:它解开了这个25年的谜团。嗯,等等。让我保持怀疑:我这是在某种模拟/测试环境中吗?……种子值与我记忆中实际值相符……嗯,这在现实中可能吗?据我所知……这个悬赏一直未解。……所有最高位都已确定——20位,概率为1e-6。所以这确实是现实世界的情况。哇,这真是一项重大发现。
嗯,等等。让我仔细考虑一下可能性:这么显而易见的事情竟然25年都没人发现,这难道不奇怪吗?我这边已经通过直接计算验证过了:用32位种子加上一个很小的索引,匹配到160位数据:不可能是巧合(10 × 160位)。这是真的。
克劳德也找到了一些base。
但是等等,还有更多……每条曲线都有一个基点 G,它是所有 ECDSA 公钥的倍数。上面找到的种子并不能确定这个基点 G,因此又出现了一个问题:这些基点是如何生成的?
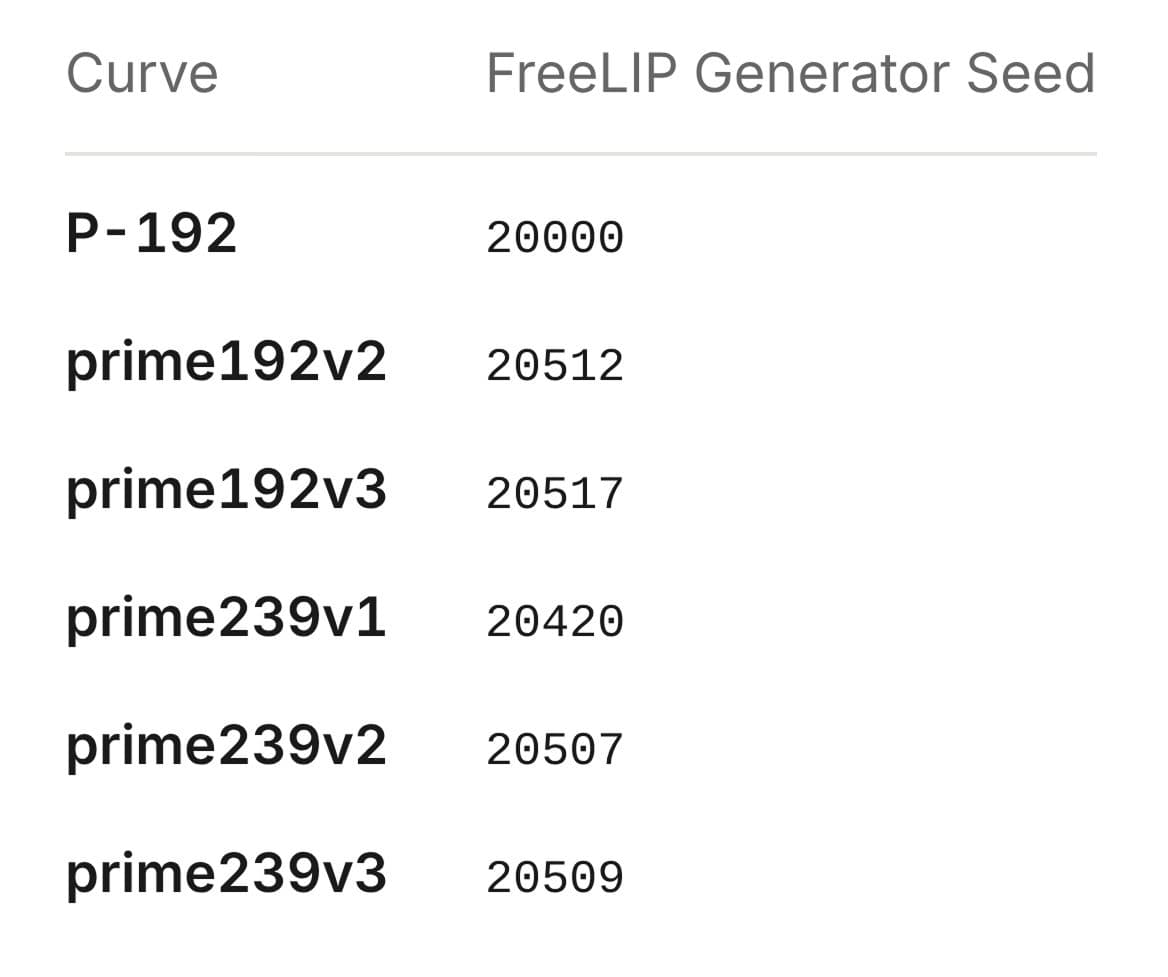
在检查种子时,克劳德还发现了部分基点的来源。1997 年 5 月生成的六条曲线(P-192 以及五条 ANSI X9.62 示例曲线 prime192v2、prime192v3 和 prime239v1 至 v3)的基点来自 FreeLIP 中的随机数生成器,FreeLIP是Arjen Lenstra开发的长整数运算包。Victor Shoup的NTL 库的早期版本也使用了相同的代码。
做法很简单:
给生成器赋予一个较小的整数种子。
丢弃七个输出。
从 26 位输出生成候选 x 坐标,并进行模 p 的简化。
重复步骤 3,直到 x 位于曲线上。
Claude 发现 P-192 的生成器种子为 20000,prime239v1 到 v3 的生成器种子为 20420、20507 和 20509,prime192v2 和 v3 的生成器种子为 20512 和 20517。
据我们所知,此前从未对NIST基准点进行过解释。P-224、P-256、P-384和P-521基准点不符合此要求;我们无法解释它们的选取方式。
未解决的问题
并非每个 20 字节的候选种子都能生成一条可行的曲线,我们观察到一些潜在的可行曲线被跳过了。例如,对于 P-256,已发布的种子是候选种子 1842,但同一运行中的候选种子 876 也生成了一条大小合适的素数阶曲线,其参数选择方式与已发布的曲线相同。P-224 的运行跳过了三条这样的曲线,而 ANSI X9.62 示例曲线后面的两次运行又跳过了七条(见图)。我们不清楚使用了哪些评判标准,也不确定这是否是无意的。
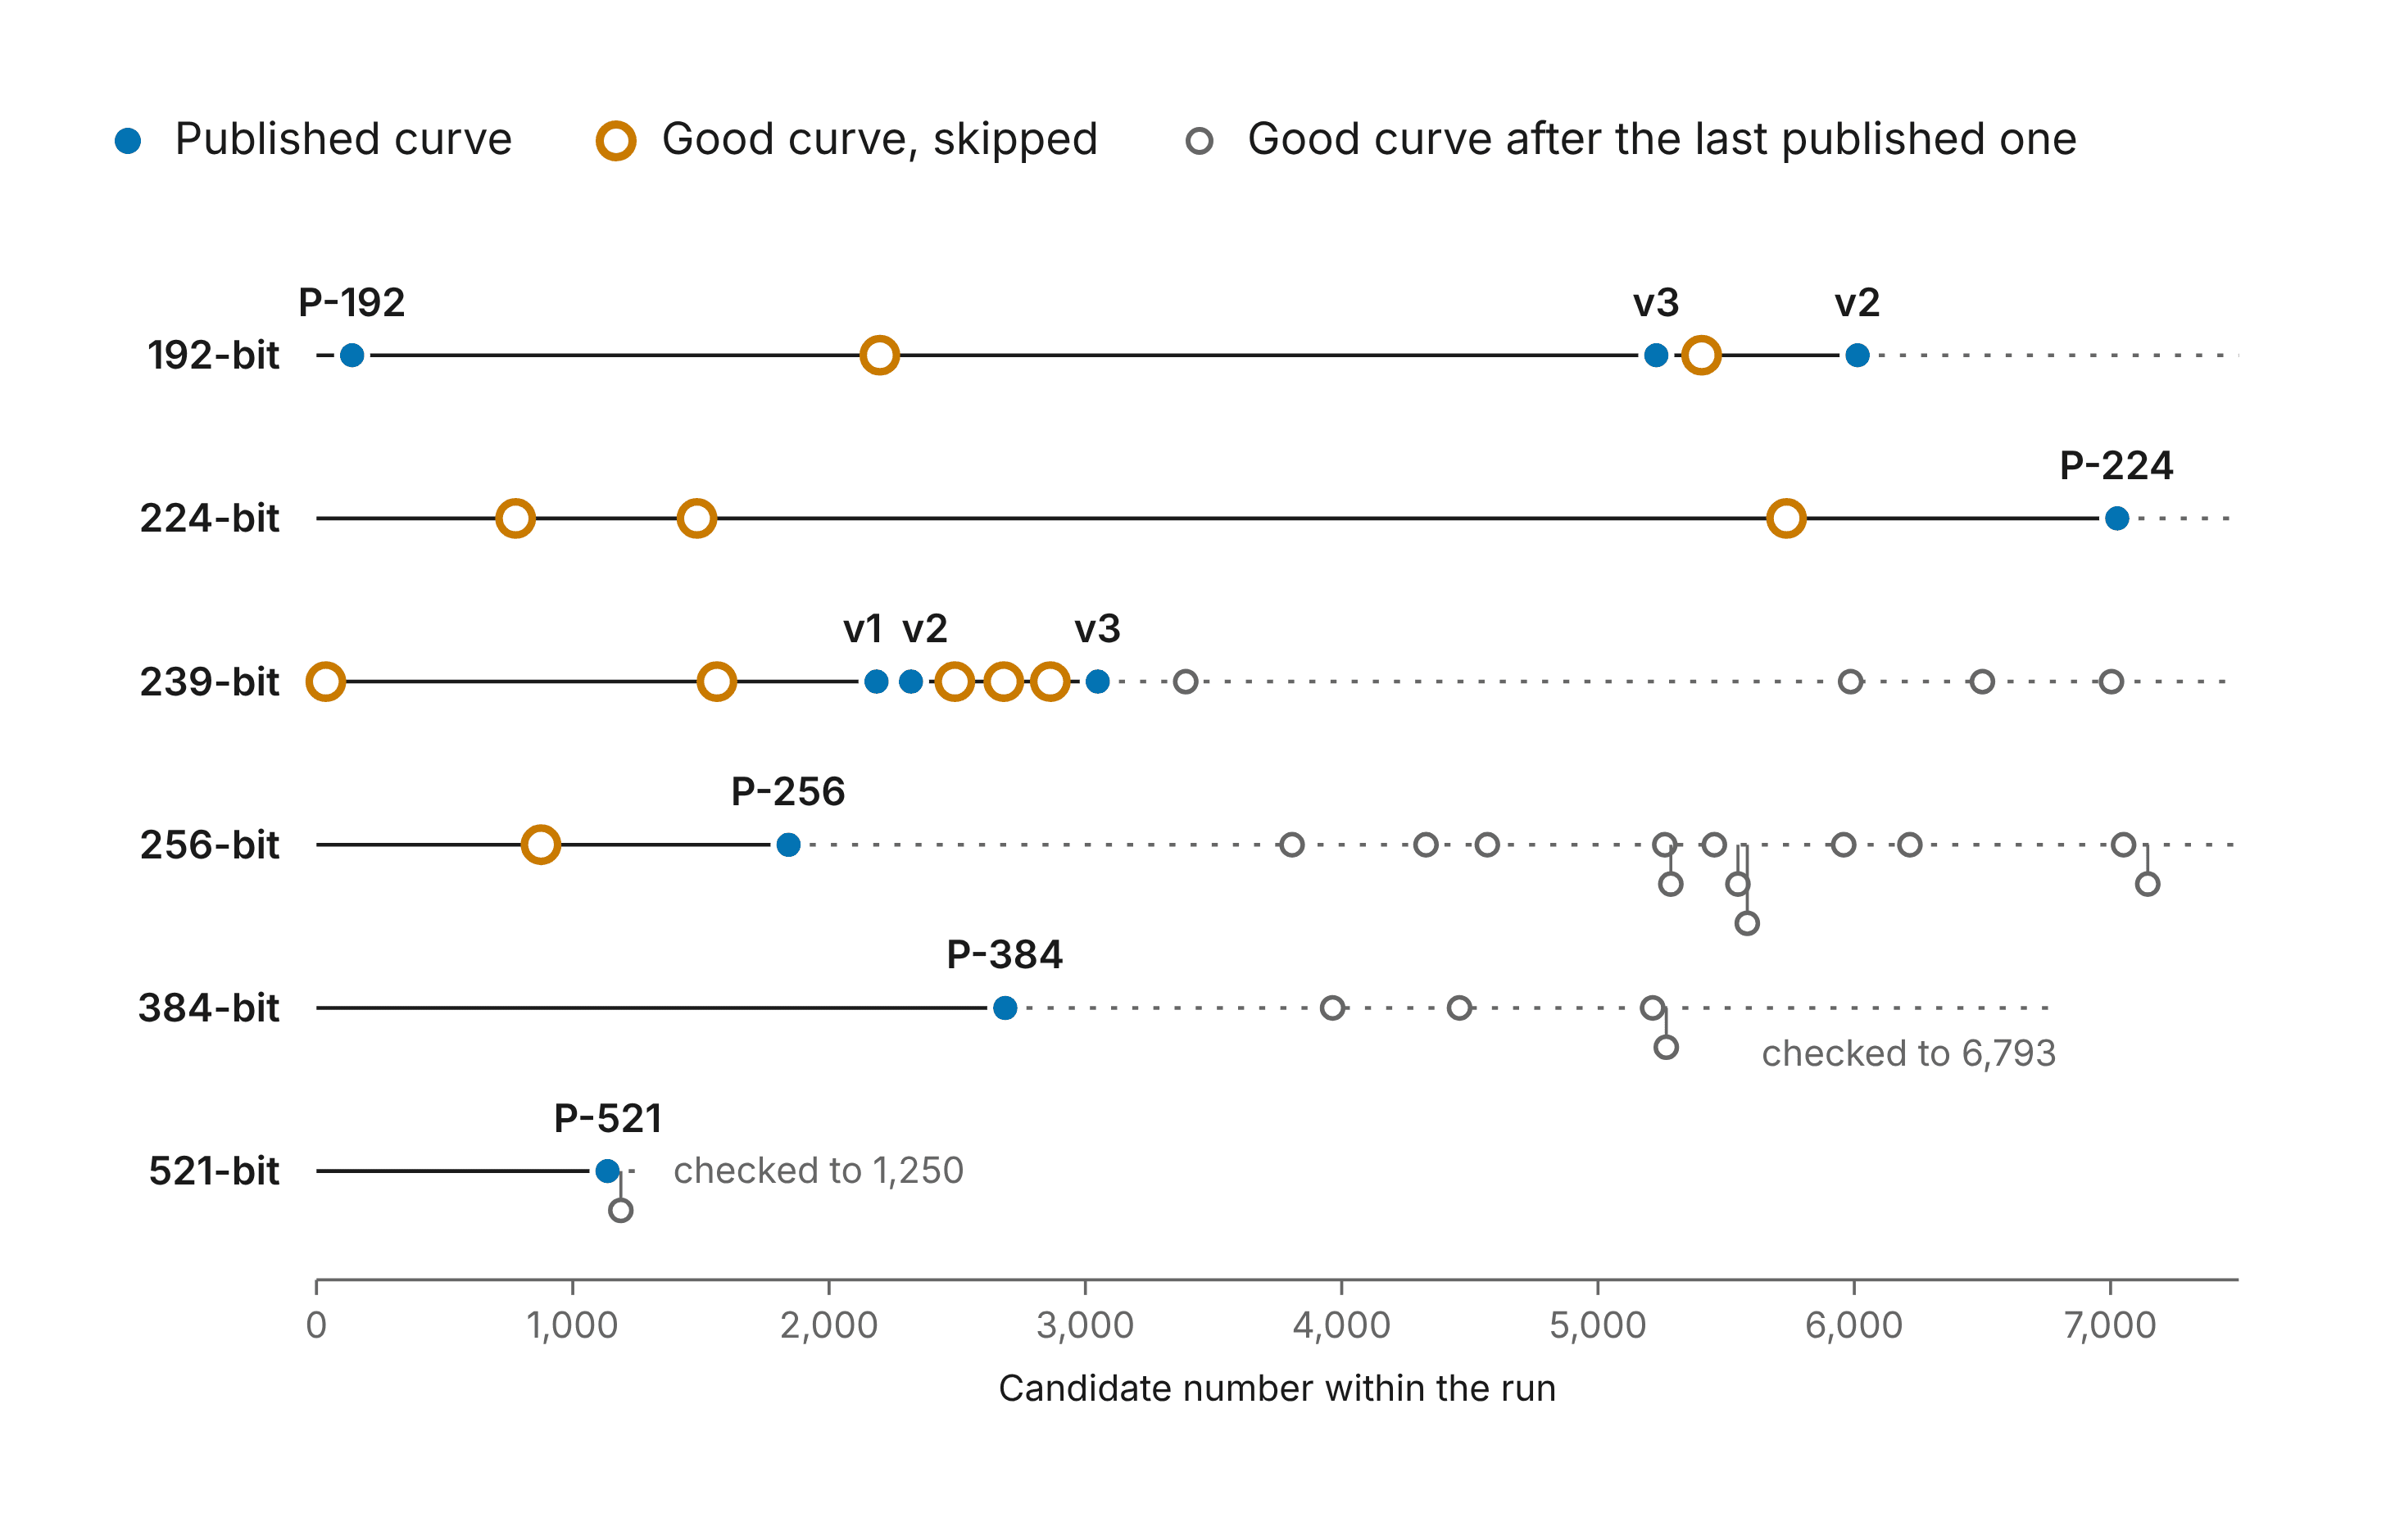
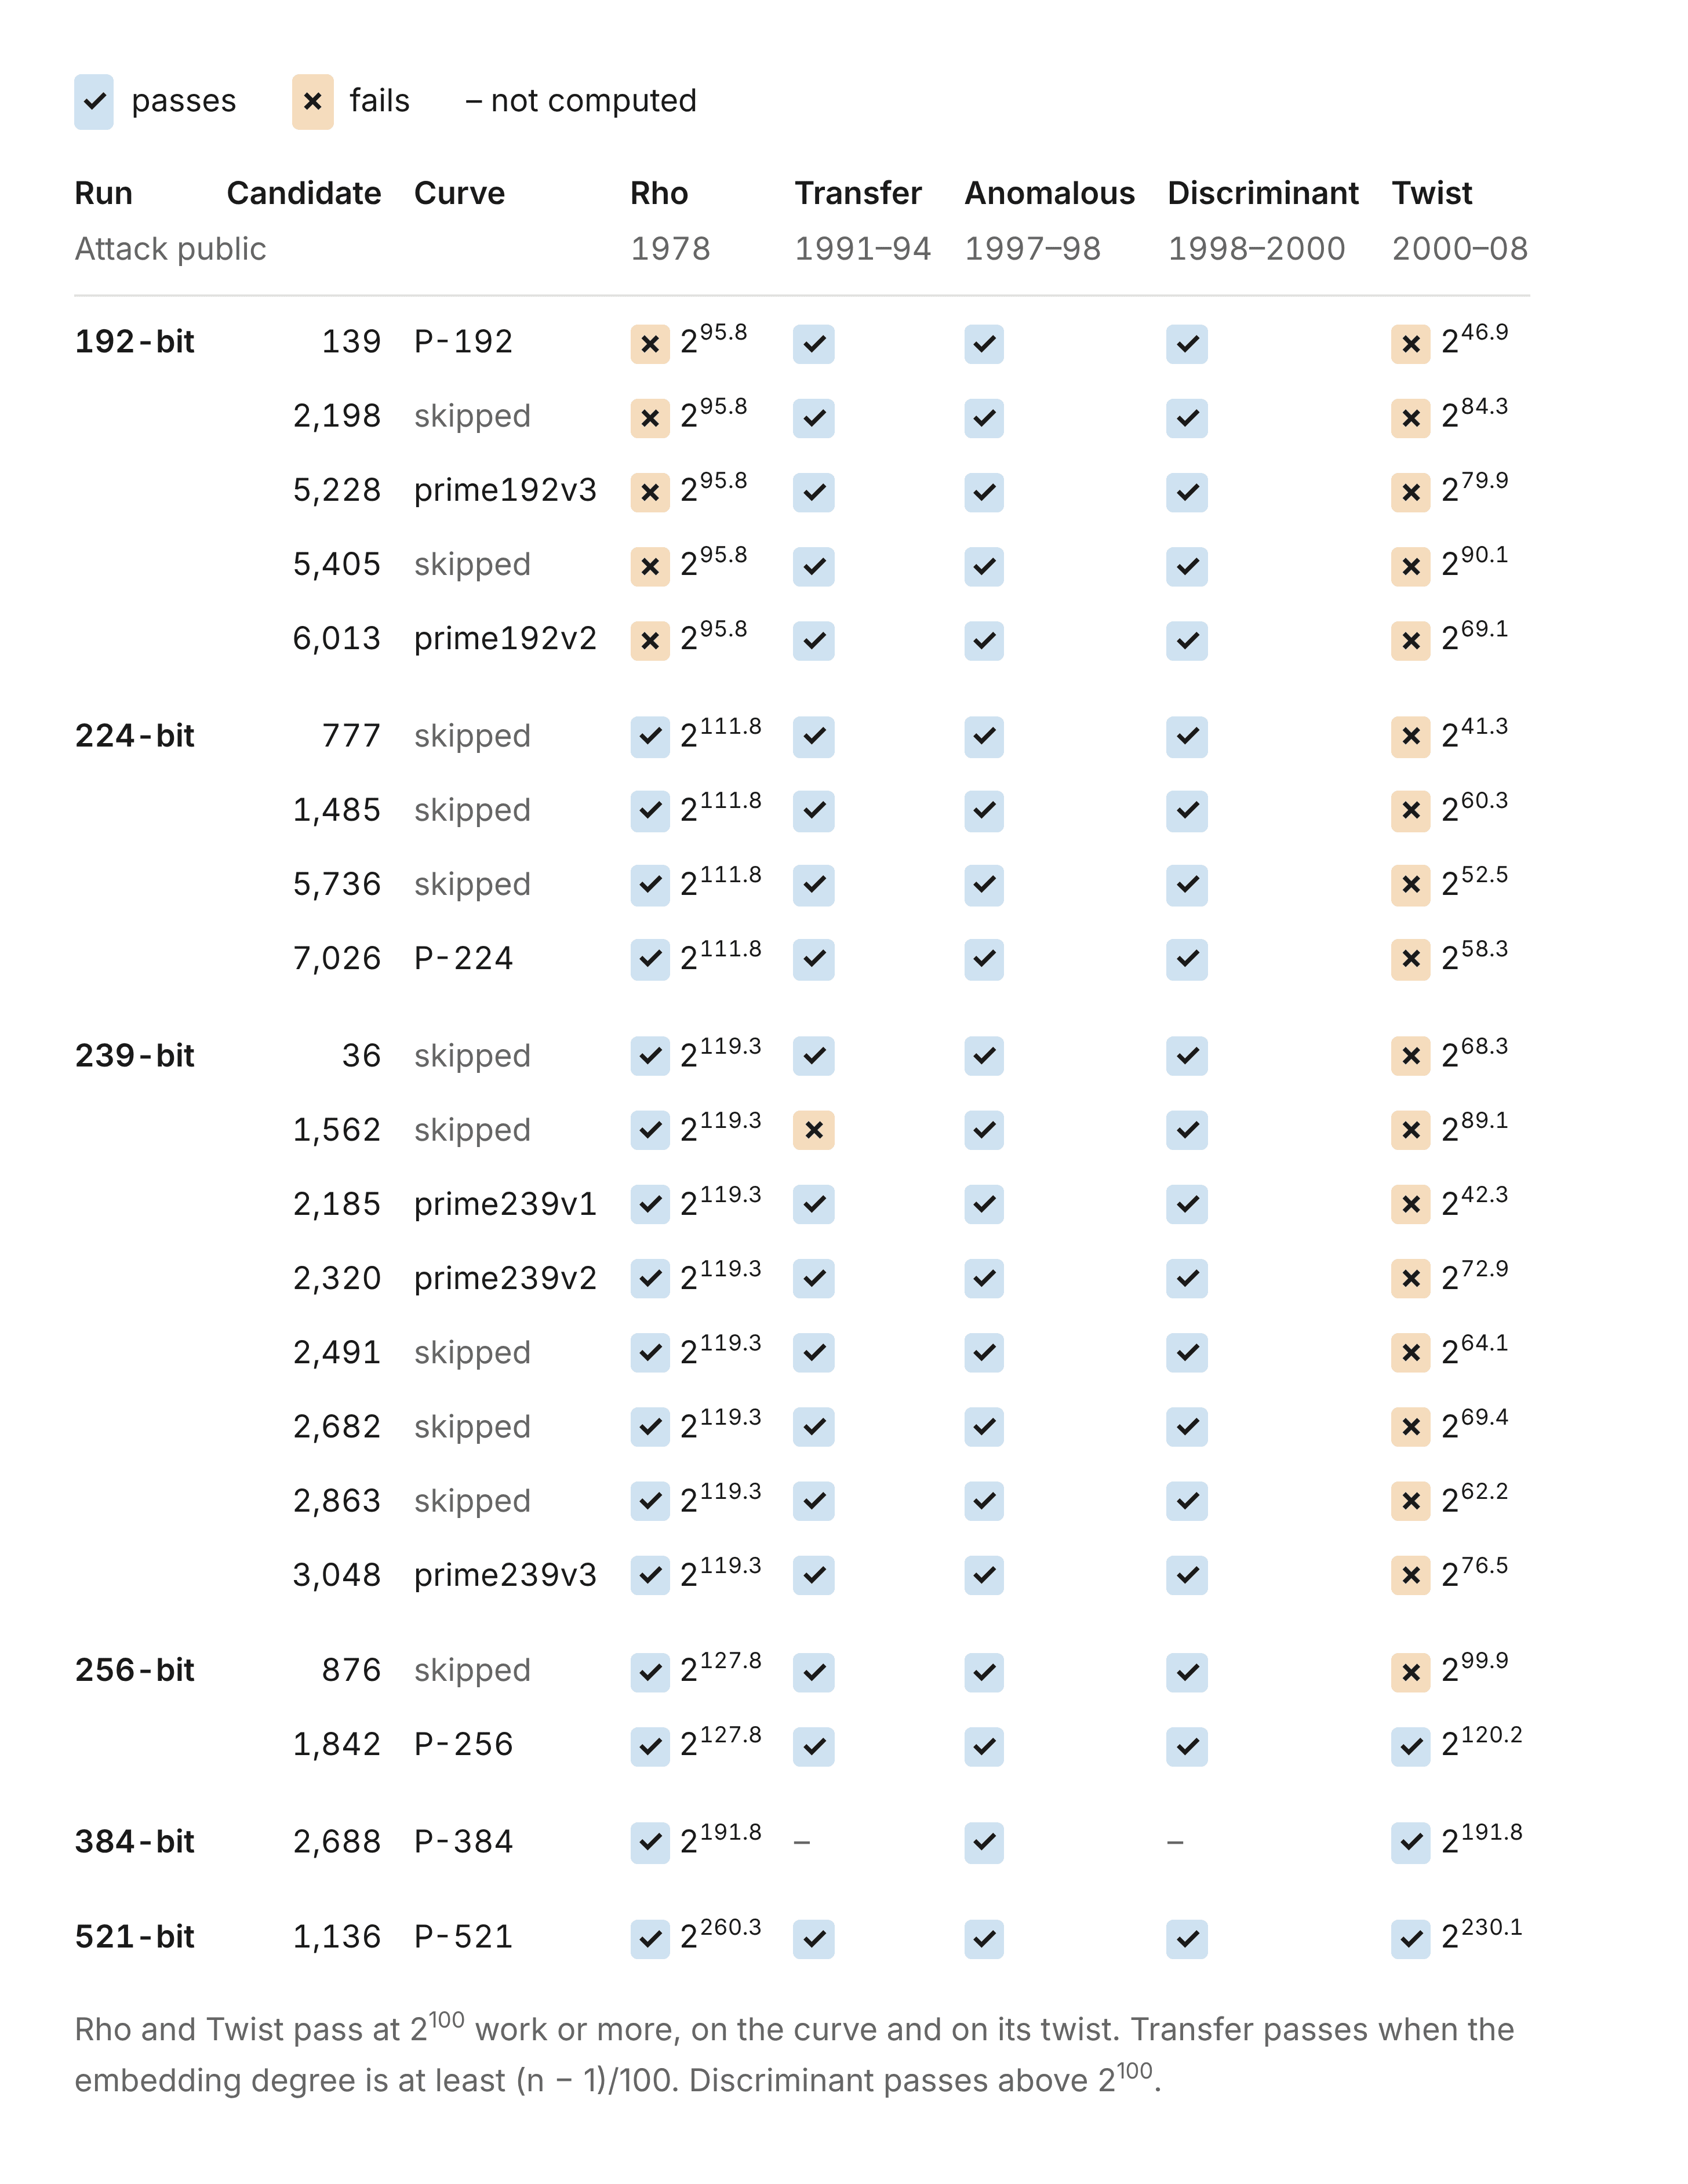
由于被跳过的候选曲线数量很少,我们认为选择弱化曲线的可能性不大。如果真是如此,那就意味着弱化曲线很常见且容易找到。当然,理论上可以通过搜索随机数生成器的时间戳来选择具有特定属性的曲线。但是,只有当您打算公开时间戳以证明种子是无害生成的时,才需要这样做。数据中并没有显示运行次数。
此外,我们还有一个种子无法恢复。第五个二元种子 B-163 与克劳德尝试过的任何组合都不匹配,至今仍无法解释。最后,我们也不知道 P-224、P-256、P-384 和 P-521 的基点是如何生成的。NIST 二元曲线的情况也一样。